在 Mac 上私密地就 PDF 提问
就 PDF、扫描件或文档提问,并根据其中的内容得到答案。
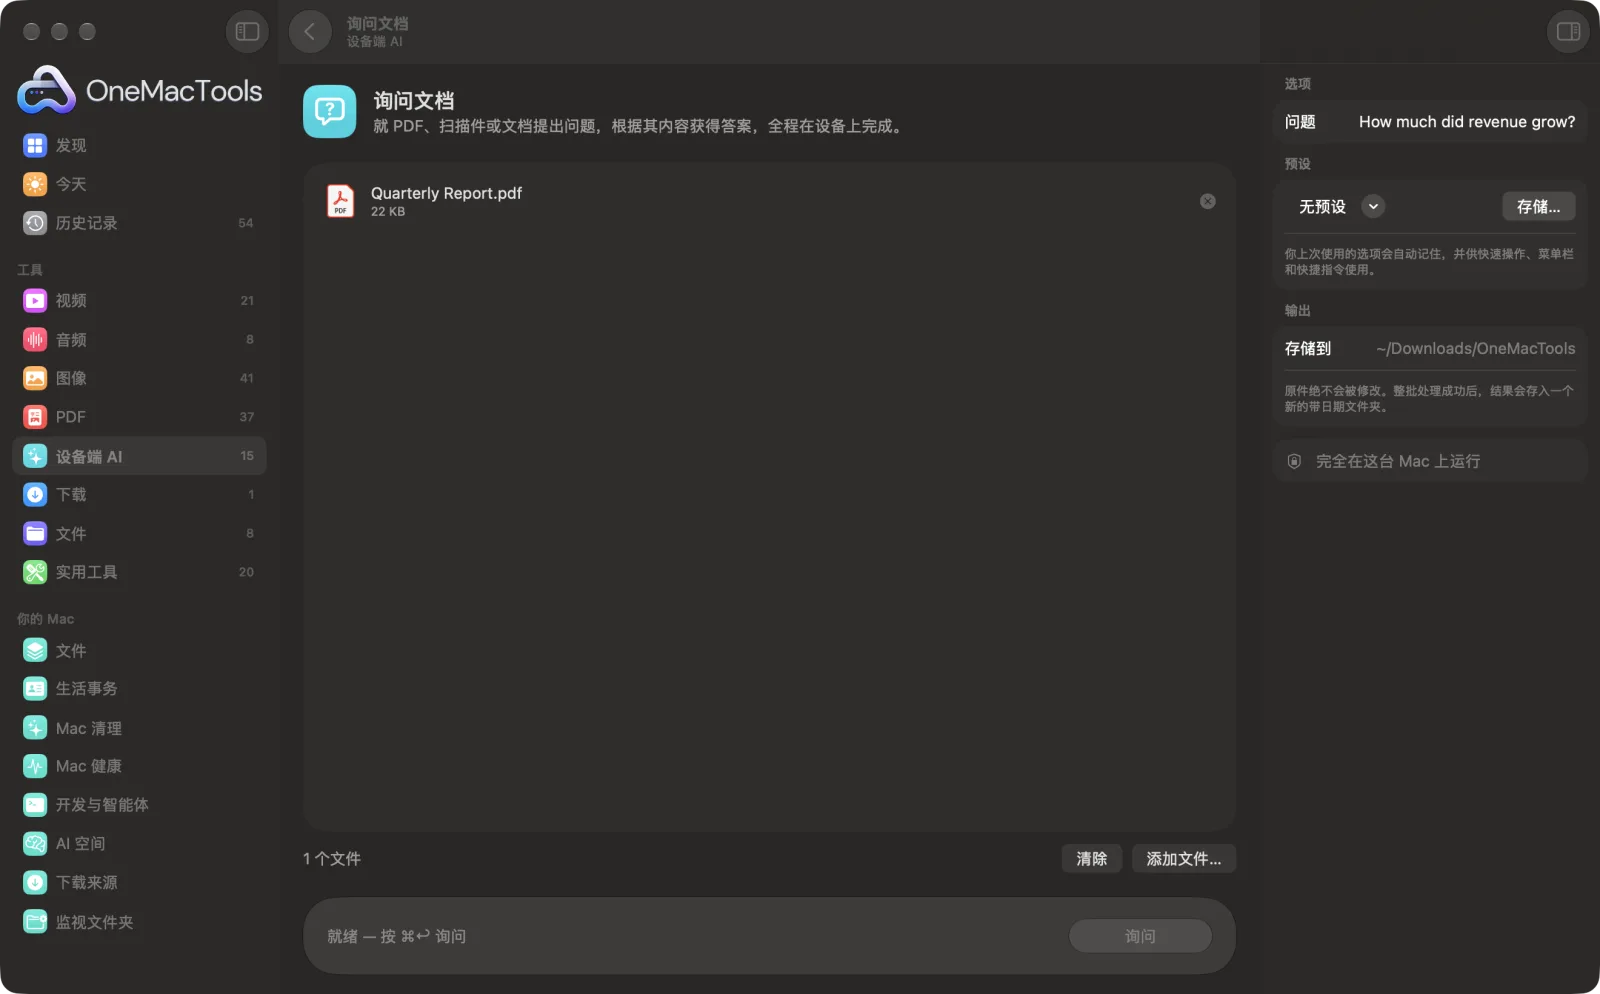
Mac 上的询问文档
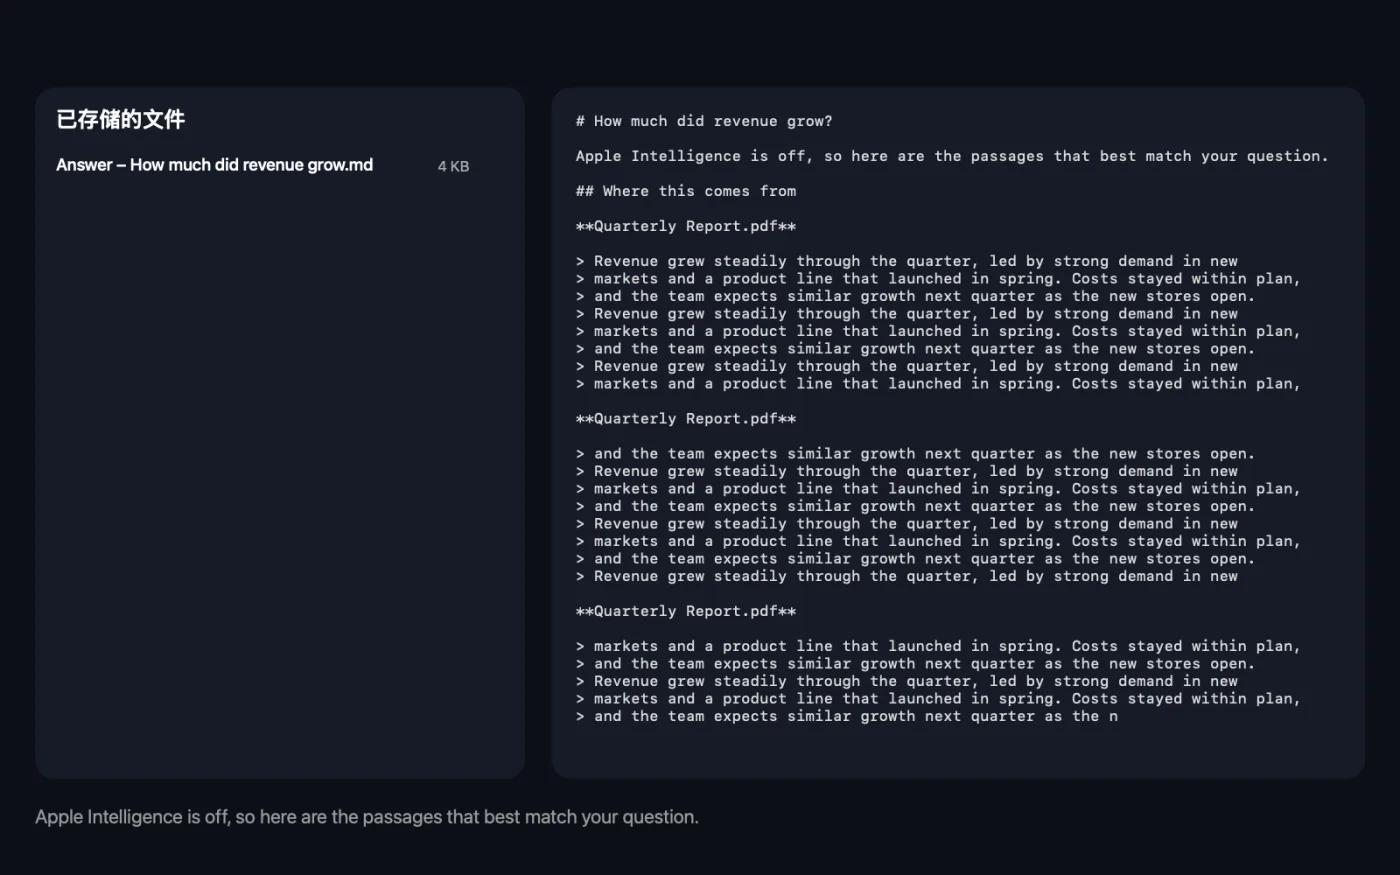
App 截图,使用的是示例文件。
如何使用询问文档
- 1
添加文档
将一个或多个 PDF、扫描件、页面照片、Word 文档或文本文件拖到“询问文档”上。可以同时针对多个文件提问。
- 2
输入你的问题
在右侧面板的“问题”中输入问题,例如“付款截止日期是什么时候?”或“通知期是多久?”。
- 3
点按“询问”
OneMacTools 会读取文件(扫描件使用设备端文字识别),找出与你问题中的词语最匹配的段落。然后由 Apple Intelligence 的设备端模型仅根据这些段落作答。
- 4
阅读答案
窗口中会显示简短版答案。完整答案会以你的问题命名,存储为 Markdown 文件,放在“下载 › OneMacTools”中新建的带日期文件夹里。
- 5
检查来源
用“预览”(眼睛)按钮打开文件。答案下方会引用其出处段落并注明文件名,方便你在采取行动前核实。
询问文档的功能
输入一个问题,比如“付款截止日期是什么时候?”,OneMacTools 会找出最相关的段落,并用 Apple Intelligence 的设备端模型作答。答案会与其出处段落一起存储,方便你核对。
打开 Apple Intelligence 时使用其设备端模型,关闭时改用设备端文字识别。
适合
- 在冗长的合同中找到截止日期
- 查看政策中关于退款的规定
- 从报告中找出关键数字
选项说明
- 问题
- 你想要得到解答的问题;没有问题工具就不会运行。系统会通过匹配问题中的词语来查找段落,因此请使用文档中可能出现的词语,例如“termination”或“refund”。
最佳实践
- 一次只问一件具体的事。“逾期付款费用是多少?”比“讲讲付款的事”效果更好。
- 请使用文档自己的措辞。“通知期”比“我要提前多久才能离职”更容易找到写有“通知期”的条款。
- 对于任何重要的内容,例如日期、金额或法律条款,请阅读回答下方引用的段落。回答的准确性取决于这些摘录,而 AI 也可能误读它们。
- 如果回答说摘录中没有相关内容,请换个说法,或询问更具体的问题。
- 如果想要概览而不是某个具体信息,请改用“总结”。
- 每个 PDF 只读取前 60 页。较长的报告请先用“提取页面”取出需要的部分。
兼容
- 输入
- PDF(包括扫描件)、页面图像、Word (.docx)、RTF、HTML、Markdown、纯文本和 SRT 文件。
- 输出
- 一个 Markdown (.md) 文件,包含你的问题、答案及其出处段落,窗口中还会显示简短答案。
- 每个 PDF 最多读取 60 页。
- 段落是按词语匹配而不是按含义查找的,因此如果问题的用词与文档不同,可能会错过正确的部分。
- 关闭 Apple Intelligence 后,你会得到最匹配的段落,但没有撰写好的回答。
关于询问文档的问题
如何在 Mac 上就 PDF 提问而无需上传?
将 PDF 拖到“询问文档”上,在右侧面板中输入问题并点按“询问”。文件的读取和问题的回答都由 Apple Intelligence 的设备端模型在你的 Mac 上完成。
可以对多个文档提出同一个问题吗?
可以。全部拖进来。会使用所有文件中最匹配的段落,每段引文都会注明出自哪个文件。
它适用于扫描版 PDF 和文档照片吗?
可以。扫描页面和图像会先通过 macOS 内置的文字识别读取,再回答你的问题。
如何确认答案是对的?
每个回答都会连同其依据的段落一起存储,这些段落会附上文件名引用在下方。在依赖某个日期、数字或条款之前,请先核对这些段落。
如果文档中没有答案会怎样?
模型会被要求直接说明,而不是猜测。如果文档中完全没有与你问题中的词语匹配的内容,你会看到“这些文档中似乎没有与该问题相关的内容。”
可以保存我的问题和答案记录吗?
可以。每个问题都会存储为单独的文件,命名为“Answer – ”加上你的问题,因此问几个问题就能积累一组答案,与文档放在一起保存。
询问文档会上传我的文件吗?
不会。询问文档完全在你的 Mac 上运行,文件绝不会离开你的 Mac,离线也能用。
询问文档会改动我的原文件吗?
不会。结果会存储为新文件,放在“下载 › OneMacTools”中带日期的文件夹里;除非你打开了另有说明的选项,否则原文件会原封不动。
询问文档需要 Apple Intelligence 吗?
打开 Apple Intelligence 时,它会使用其设备端模型,效果最佳。关闭时,OneMacTools 会改用设备端文字识别和规则,并告知你。
下一步
借助 Apple Intelligence 的设备端模型获取长文档的摘要。
提取页面将需要的页面提取到新的 PDF 中。
提取文本用 Apple 的 Vision 框架识别照片、截图和扫描 PDF 中的文字。