Mac에서 이미지와 스캔한 PDF의 텍스트 추출하기(OCR)
Apple Vision 프레임워크로 사진, 스크린샷, 스캔한 PDF에서 텍스트를 읽어요.
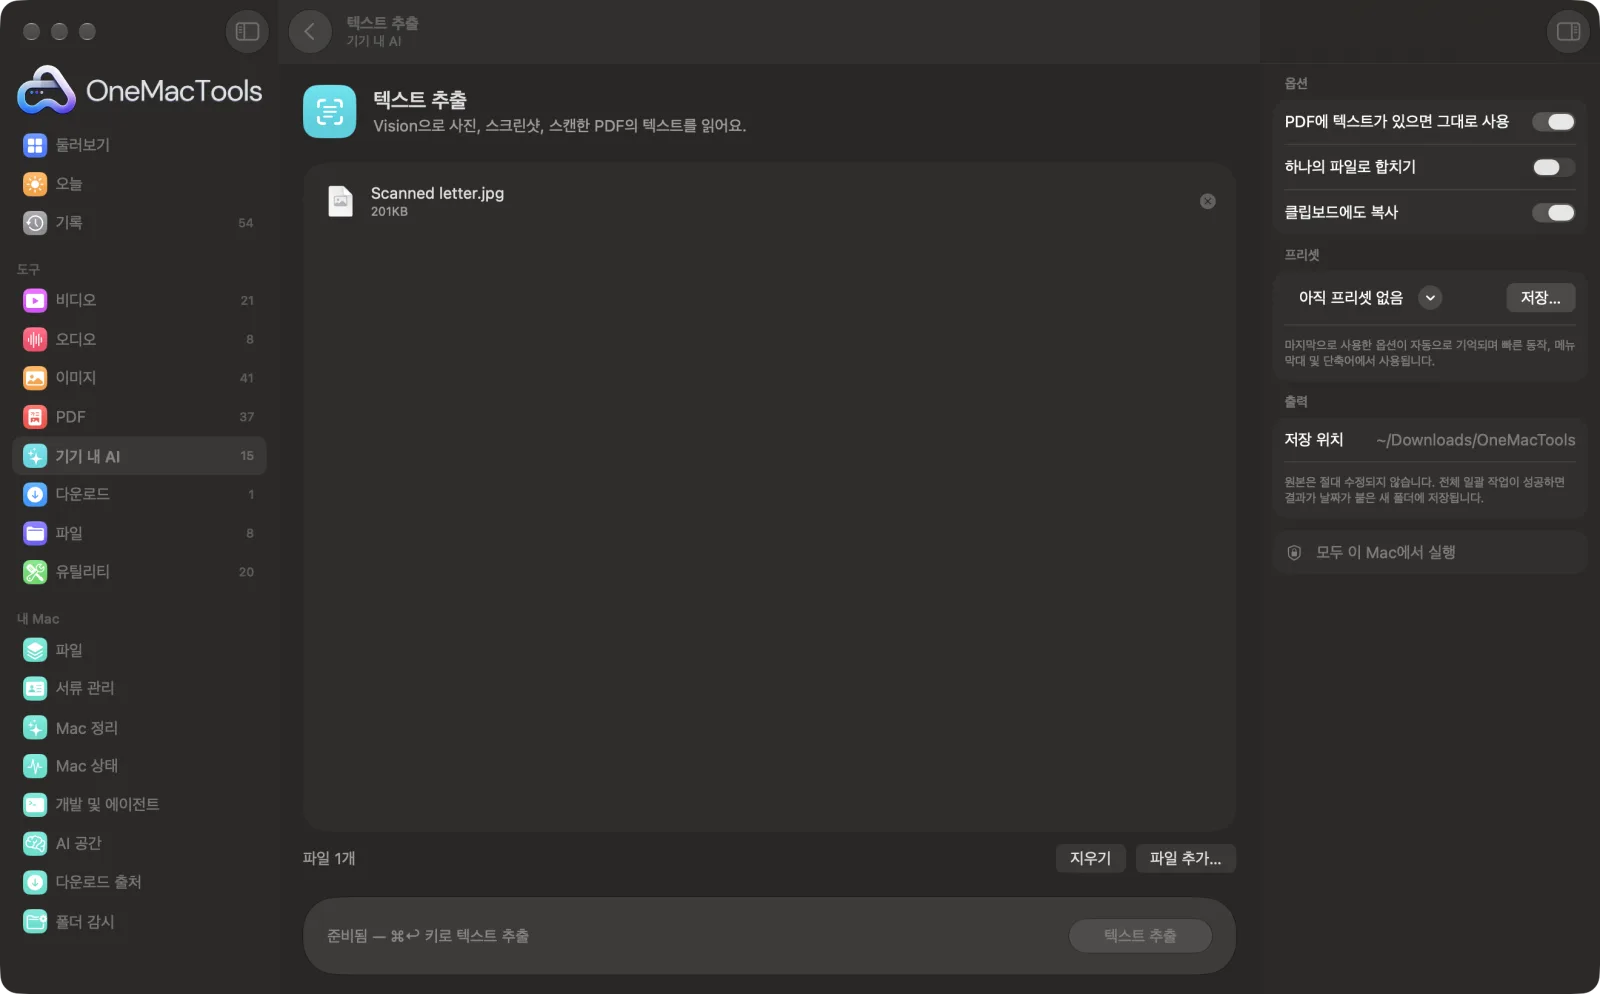
Mac의 텍스트 추출
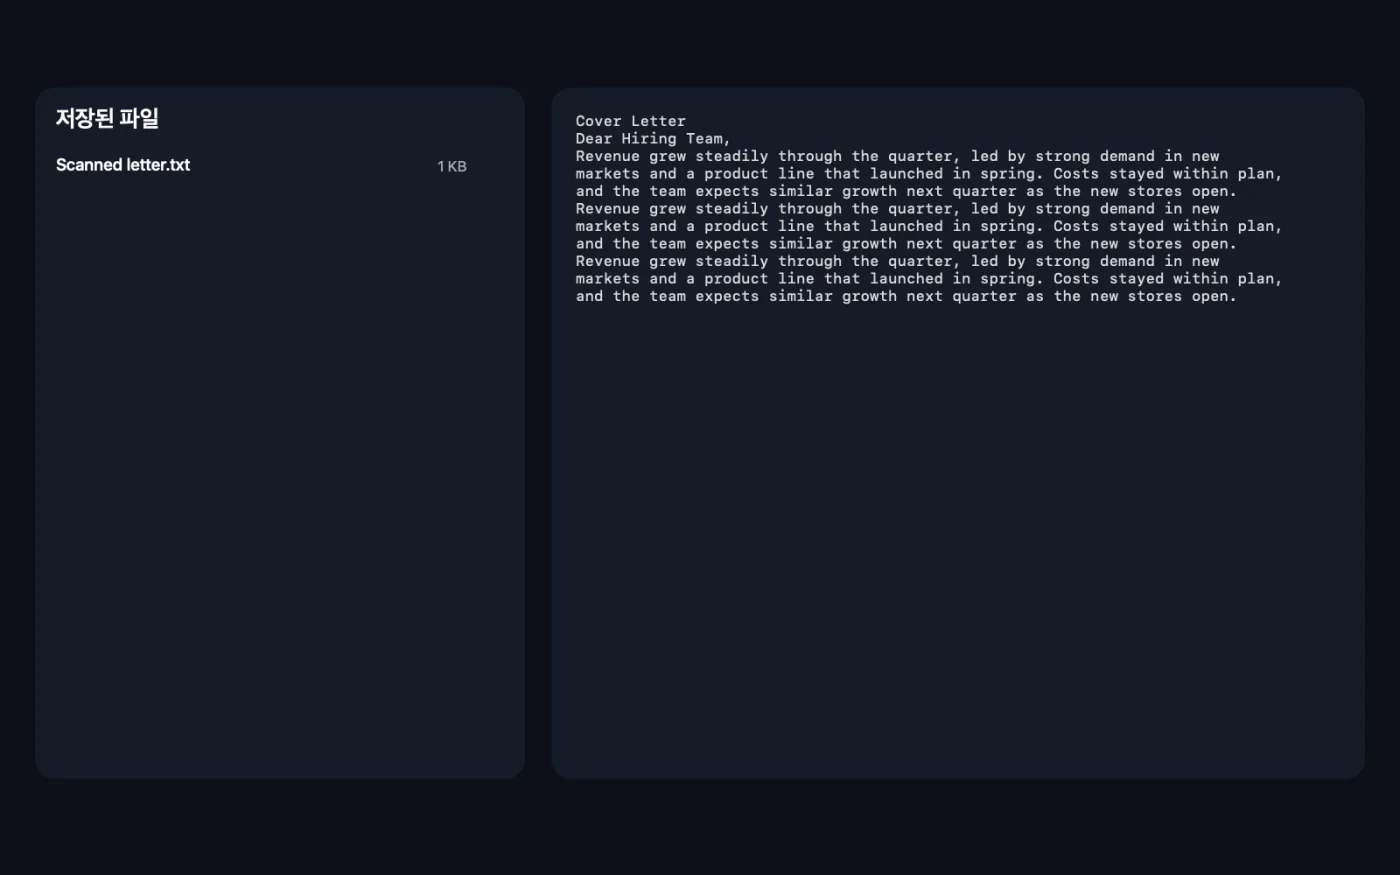
샘플 파일을 사용한 앱 스크린샷.
텍스트 추출 사용 방법
- 1
파일 추가
사진, 스크린샷, 스캔한 PDF나 일반 PDF를 텍스트 추출에 놓으세요. 또는 Finder에서 선택하고 오른쪽 클릭한 다음 빠른 동작 › OMT: 텍스트 추출를 선택하세요. 마지막으로 사용한 설정이 적용돼요.
- 2
옵션 확인
오른쪽 패널에서 PDF 자체의 텍스트를 사용할지, 모든 내용을 파일 하나로 합칠지, 결과를 클립보드에 복사할지 선택하세요.
- 3
추출 클릭
각 이미지와 PDF 페이지를 macOS에 내장된 텍스트 인식으로 읽어요. 언어는 알아서 감지해요.
- 4
텍스트 사용하기
클립보드에도 복사를 켜 두면 텍스트를 바로 붙여 넣을 수 있어요. .txt 파일은 다운로드 › OneMacTools 안의 새 날짜별 폴더에 저장되니, 미리보기(눈 모양) 버튼이나 Finder에서 보기로 여세요.
텍스트 추출의 기능
이미지나 PDF를 놓으면 텍스트를 .txt 파일로, 하나로 합치거나 파일마다 하나씩 저장하고 클립보드에도 복사해요. 인식은 Mac에서 실행되며 언어를 자동으로 감지해요. 이미 텍스트가 들어 있는 PDF는 바로 읽어요.
Finder 빠른 동작으로도 쓸 수 있어요. 파일을 오른쪽 클릭하고 OMT: 텍스트 추출을 선택하세요.
이럴 때 좋아요
- 인쇄된 노트 디지털화
- 화이트보드 사진에서 텍스트 복사
- 스캔한 편지 검색하기
옵션 설명
- PDF에 텍스트가 있으면 그대로 사용
- 기본값은 켜짐이에요. PDF 페이지에 이미 실제 텍스트가 있으면 그 텍스트를 그대로 써서 더 빠르고 정확해요. 텍스트가 거의 또는 전혀 없는 페이지는 이미지로 읽어요. PDF의 내장 텍스트가 깨지거나 순서가 뒤섞여 나올 때처럼 모든 페이지를 이미지로 읽으려면 끄세요.
- 하나의 파일로 합치기
- 기본값은 꺼짐이라 파일마다 같은 이름의 .txt가 따로 만들어져요. 켜면 “Extracted Text.txt” 파일 하나에 각 파일의 텍스트가 파일 이름을 적은 줄 아래에 담겨요.
- 클립보드에도 복사
- 기본값은 켜짐이에요. 놓은 모든 항목의 텍스트를 복사하므로 파일을 열지 않고도 이메일, 메모, 문서에 붙여 넣을 수 있어요.
권장 사항
- 텍스트는 정면에서 밝은 곳에서 초점을 맞춰 찍으세요. 선명하고 고르게 밝은 사진이 비스듬하거나 그늘진 사진보다 훨씬 잘 읽혀요.
- 이미 화면에 있는 텍스트라면 화면에서 텍스트 가져오기가 더 빨라요. 원하는 영역을 드래그하면 텍스트가 복사돼요.
- 별도의 텍스트 파일 대신 검색하고 선택할 수 있는 PDF를 원한다면 PDF 검색 가능하게를 사용하세요. 인식한 텍스트를 PDF 자체에 더해요.
- 깔끔한 손글씨는 읽을 수 있는 경우가 많지만, 결과를 믿기 전에 이름, 숫자, 날짜를 원본과 대조해 보세요.
- 줄바꿈은 그림 속 줄을 따르므로 단락이 끊겨 나올 수 있어요. 텍스트를 텍스트 정리에 붙여 넣고 PDF 때문에 끊어진 줄을 이으세요.
- 표는 텍스트 줄로 나와요. 행과 열을 유지해야 한다면 PDF를 Excel로를 쓰세요.
함께 쓸 수 있는 곳
- 입력
- macOS가 열 수 있는 이미지(JPEG, PNG, HEIC, TIFF, 스크린샷 등)와 PDF(스캔본 포함).
- 출력
- 일반 텍스트(.txt) 파일(파일마다 하나 또는 모두 하나로)과 클립보드 사본.
- PDF가 아무리 길어도 모든 페이지를 읽어요.
- 다단 레이아웃과 표는 구조가 유지되지 않을 수 있어요.
- 앱을 연 뒤 처음 실행할 때는 macOS가 텍스트 인식을 불러오느라 조금 더 걸릴 수 있어요.
텍스트 추출에 관한 질문
Mac에서 이미지 속 텍스트를 복사하려면 어떻게 하나요?
이미지를 텍스트 추출에 놓고 추출을 클릭하세요. 텍스트가 .txt로 저장되고 클립보드에 복사돼요. 화면에 보이는 내용이라면 화면에서 텍스트 가져오기로 원하는 영역을 드래그하면 돼요.
어떤 언어를 읽을 수 있나요?
macOS에 내장된 텍스트 인식을 사용하고 언어를 자동으로 감지하므로 영어에 한정되지 않아요. macOS 텍스트 인식이 지원하는 언어를 읽어요.
스캔한 PDF도 읽을 수 있나요?
네. 텍스트를 찍은 그림인 페이지는 기기 내 텍스트 인식으로 읽어요. 이미 텍스트가 있는 페이지는 “PDF에 텍스트가 있으면 그대로 사용”을 끄지 않는 한 바로 읽어요.
손글씨도 읽을 수 있나요?
깔끔한 손글씨는 잘 되는 편이지만, 인쇄된 텍스트보다 결과 편차가 훨씬 커요. 중요한 내용은 원본과 대조해 보세요.
PDF에서 가져온 텍스트가 뒤죽박죽인 이유는 무엇인가요?
일부 PDF는 텍스트가 이상한 순서로 저장되어 있거나 글자가 깨져 있어요. “PDF에 텍스트가 있으면 그대로 사용”을 끄면 각 페이지를 이미지로 읽어요.
많은 이미지에서 텍스트를 한 번에 추출할 수 있나요?
네. 원하는 만큼 놓으세요. 각각 .txt 파일이 만들어지며, 하나의 파일로 합치기를 켜면 파일 이름 아래에 하나씩 모두 한 파일에 담겨요.
대신 PDF의 텍스트를 Word로 옮기려면 어떻게 하나요?
PDF를 텍스트 및 Word로를 쓰세요. 편집할 수 있는 .docx로 저장하고 스캔한 페이지도 읽어요.
텍스트 추출이(가) 내 파일을 업로드하나요?
아니요. 텍스트 추출은(는) 전적으로 Mac에서 실행되므로 파일이 Mac 밖으로 나가지 않고 오프라인에서도 작동해요.
텍스트 추출이(가) 원본 파일을 바꾸나요?
아니요. 결과는 다운로드 › OneMacTools의 날짜별 폴더에 새 파일로 저장되고, 따로 적힌 옵션을 켜지 않는 한 원본은 그대로 남아요.
텍스트 추출에는 무엇이 필요한가요?
macOS 26 이상이 설치된 Mac만 있으면 돼요. 따로 설치할 것은 없어요.
Finder에서 텍스트 추출을(를) 쓸 수 있나요?
네. Finder에서 파일을 오른쪽 클릭하고 빠른 동작 › “OMT: 텍스트 추출”을 고르세요. 백그라운드에서 실행되고 끝나면 알려 줘요.
다음으로 할 일
비디오, 사진, 잠긴 PDF 등 화면의 무엇이든 드래그해서 그 안의 텍스트를 복사해요.
PDF 검색 가능하게스캔한 PDF에 보이지 않는 OCR 텍스트 레이어를 추가해 텍스트를 검색, 선택, 복사할 수 있게 해요.
PDF를 텍스트 및 Word로PDF의 텍스트를 Word 문서, 일반 텍스트, RTF로 꺼내요. 스캔한 페이지는 OCR로 읽어요.